Un chat IA ne comprend pas votre question comme le ferait un collègue. Il devine, morceau après morceau, la suite la plus probable de votre message. C'est ce qui explique qu'il réponde si bien, et qu'il se trompe parfois avec aplomb.
Entre le moment où vous envoyez votre question et celui où la réponse s'affiche, il se passe quatre choses. Vous ne les voyez pas, mais elles expliquent tout le reste.
Ces petits morceaux de mots s'appellent des tokens. Le programme qui écrit la réponse s'appelle le modèle (on dit aussi LLM, pour « grand modèle de langage »). Il n'écrit jamais une phrase d'un coup : il ajoute un token, relit le tout, puis ajoute le suivant.
À retenir : le chat IA donne une réponse probable, pas une réponse vérifiée. À chaque token, il choisit parmi plusieurs suites possibles. L'exemple qui suit le montre.
Deviner la suite
Le modèle ne comprend pas : il devine la suite
Prenez le début de phrase « Le chat est… ». Le modèle donne à chaque suite possible un pourcentage de chances. Puis il choisit, presque toujours, l'une des plus probables.
Le chat est ___
mignon
28 %
gros
19 %
noir
14 %
parti
9 %
là
7 %
… autres
23 %
Pourcentages donnés pour l'exemple. Le modèle recommence ainsi pour chaque token, jusqu'à la fin de la réponse.
À vous de jouer · 5 min
Devinez le mot suivant
L'IA écrit en choisissant, mot après mot, parmi les suites possibles. Chaque suite a plus ou moins de chances d'être choisie. Un réglage, la température, décide si elle s'en tient au mot le plus probable ou si elle ose les autres. Déplacez le curseur, puis tirez un mot.
Chiffres fixés pour l'exemple : aucune IA n'est appelée, le tirage se fait dans votre navigateur.
Les tokens
L'unité réelle de calcul
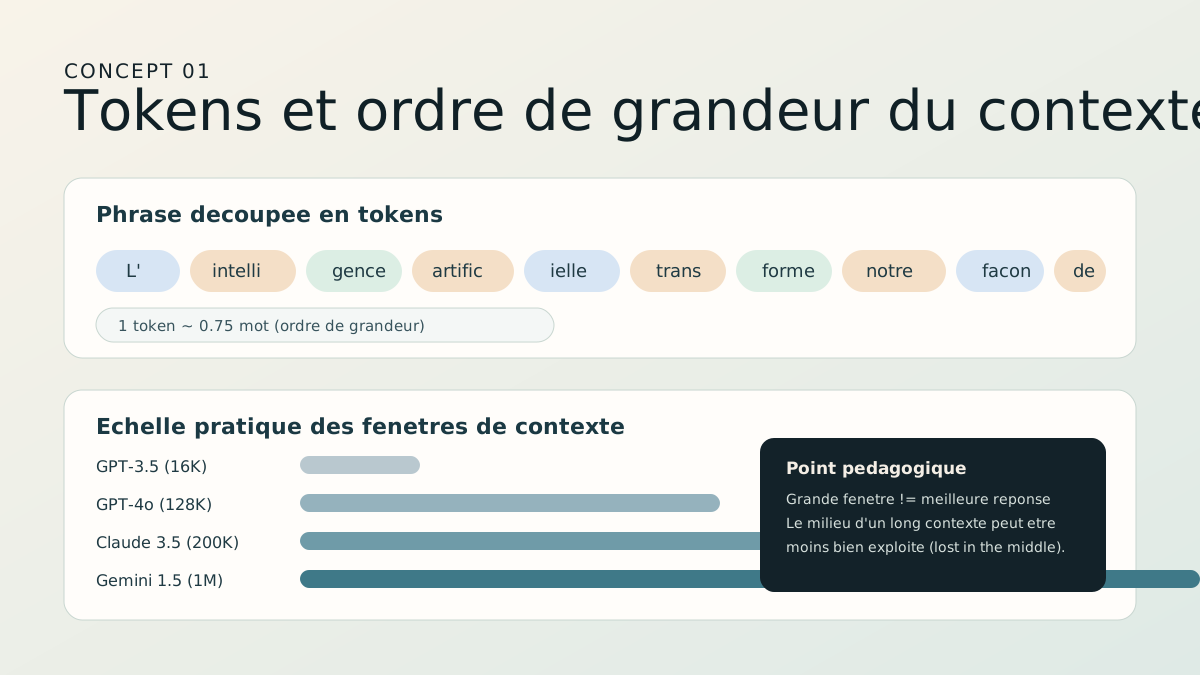
Le modèle ne lit pas des mots entiers. Il lit des morceaux de mots, les tokens. C'est avec eux qu'on mesure tout : la longueur d'un texte, le prix d'une réponse, la limite de ce que l'IA peut lire. Voici le découpage d'une phrase courante.
Bonjour, comment puis-je t'aider aujourd'hui ?
Bonjour,commentpuis-jet'aideraujourd'hui?
14tokens pour 7 mots
~ 4caractèrespar token, en français
~ 0,75motpar token en moyenne
~ 500tokenspour une page A4
~ 1 milliontokensce que les plus grands modèles lisent d'un coup (2026)
Pourquoi le prix se compte en tokens
Quand l'IA est facturée à la consommation, par exemple quand un logiciel s'y branche par une API, on paie au token, pas au mot : les tokens envoyés, plus ceux de la réponse. Une phrase de 30 mots peut représenter 50 tokens à l'envoi, et autant pour la réponse.
Pourquoi la limite se compte en tokens
Tout ce que le modèle lit entre dans le même total : vos consignes, les échanges précédents, les documents joints, votre question. Quand ce total est atteint, le début de la conversation n'est plus pris en compte.
Combien de texte un modèle peut lire d'un coup
Cette limite s'appelle la fenêtre de contexte. Elle varie beaucoup d'un modèle à l'autre. La barre montre sa taille en tokens (K = mille, M = million) ; le chiffre à droite, l'équivalent en pages A4.
GPT-3.5OpenAI · 2022
16 K
~ 32 p.A4
GPT-4oOpenAI · 2024
128 K
~ 256 p.A4
Mistral Large 3Mistral · fin 2025
256 K
~ 500 p.A4
Modèles de 2026GPT-6, Claude, Gemini
1 M
~ 2 000 p.A4
Relevé en octobre 2026 dans la documentation des éditeurs. Ces tailles changent plusieurs fois par an.
⚠ Une grande fenêtre ne garantit pas une meilleure réponse
Plus le texte à lire est long, plus son milieu risque d'être survolé. Les spécialistes parlent de « lost in the middle », perdu au milieu. La page Fenêtre de contexte y revient en détail.
Schéma téléchargeable
Le découpage en tokens et les ordres de grandeur
Comment le texte est découpé, et pourquoi on mesure en tokens ce que l'IA peut lire.
Deux personnes posent la même question avec des mots différents. Leur message à l'IA s'appelle un prompt. Suivons ce que le modèle en fait : il découpe le texte, il en repère le sens, puis il écrit la réponse.
Prompt A
Première personne : "Quel est le repas à la cantine ?"
Prompt B, dit autrement
Deuxième personne : "Que mange-t-on à la cantine ?"
1. Le découpage en tokens, ou tokenisation : la forme du texte
Prompt A"Quel est le repas à la cantine ?"
Quel1est2le3repas4à5la6cant7ine8?9
9 tokens
Prompt B"Que mange-t-on à la cantine ?"
Que1mange2-t3-on4à5la6cant7ine8?9
9 tokens
Tokens communs aux deuxPropres à APropres à B
5 tokens sur 9 sont les mêmes. Les mots changent, le sujet reste le même.
2. Le sens : deux phrases différentes, une même idée
Le modèle traduit chaque phrase en une série de notes, un peu comme une fiche : parle-t-elle de nourriture ? de cantine ? est-ce une question ? Deux phrases qui ont presque les mêmes notes veulent dire presque la même chose. Cette fiche de notes s'appelle un embedding. L'exemple est simplifié : une vraie fiche compte des centaines de notes, qui ne portent pas de nom.
ThèmePrompt APrompt B
Nourriture
0.88
0.91
Cantine
0.95
0.95
Question
0.92
0.90
Aujourd'hui
0.72
0.68
0,94
Proximité de sens (les spécialistes disent « similarité »), sur une échelle de 0 à 1. Elle est ici très élevée : les deux prompts demandent la même chose avec des mots différents.
3. La réponse : même sens, même réponse
D'abord la forme : les tokens
Prompt A
"Quel est le repas à la cantine ?"
Prompt B
"Que mange-t-on à la cantine ?"
↓
Puis le sens
Ce que la personne veut : connaître le menu de la cantine.
↓
Enfin la réponse écrite
"Le menu de la cantine aujourd'hui est : entrée salade César, plat poulet rôti et haricots verts, dessert tarte aux pommes."
9
Tokens par prompt
0,94
Proximité de sens
1
Demande reconnue
Ce qu'il faut retenir : les tokens portent la forme du texte, c'est-à-dire les mots employés. Mais c'est le sens, plus que les mots exacts, qui guide la réponse. Dans cet exemple, le menu a été fourni au modèle : sans lui, il en aurait inventé un vraisemblable.
Même mécanique, médias différents
La génération statistique s'applique à tout
Deviner le morceau suivant ne sert pas qu'à écrire du texte. Image, son, vidéo : à chaque fois, l'IA produit le morceau le plus probable, puis le suivant. Une IA qui traite plusieurs de ces médias est dite multimodale.
Le modèle prédit le token le plus probable, puis le suivant. On obtient ainsi des synthèses, des courriels, des traductions, du code informatique.
Outils : ChatGPT, Claude, Gemini, Le Chat (Mistral)
Image
Génération visuelle
À partir d'une description, le modèle prédit les points de couleur (les pixels) les plus probables. Chaque zone de l'image est dessinée en tenant compte de ses voisines.
Pour transcrire une réunion, un outil comme Whisper écoute le son et prédit les mots les plus probables. La synthèse vocale fait le chemin inverse : elle part d'un texte et produit une voix.
Outils : Whisper, ElevenLabs
Vidéo
Génération vidéo
À partir d'une description, le modèle prédit les images qui se suivent. Chaque image prolonge la précédente de la façon la plus probable.
Outils : Runway, Veo (Google), Pika
Présentation
Diaporamas & documents
À partir d'un titre ou d'un plan, le modèle produit des diapositives complètes. Le principe est le même : chaque diapo est la suite probable de la précédente.
Outils : Gamma, Beautiful.ai
À retenir
Vraisemblable ne veut pas dire exact
Texte, image, son ou vidéo : l'IA produit ce qui est vraisemblable, pas forcément ce qui est vrai, précis ou utile. Une personne doit toujours relire et vérifier.
Qualité de réponse
Les 4 facteurs qui changent le résultat
Avec le même outil, deux personnes n'obtiennent pas la même qualité de réponse. Quatre choses font la différence. Une demande écrite à la va-vite les néglige toutes ; une demande soignée les travaille toutes à la fois.
Clarté de la demande
Dites ce que vous voulez obtenir, les limites à respecter et la forme attendue. Ce que vous ne précisez pas, l'IA le choisit à votre place.
Contexte disponible
Le modèle répond à partir de ce qu'il a sous les yeux : votre message, la conversation en cours, les documents joints. De votre situation, il ne connaît que ce que vous lui montrez.
Qualité des données
Un document flou, périmé ou contradictoire donne une réponse floue, périmée ou contradictoire.
Contrôle humain
Relisez toujours. Quand la décision engage une personne, de l'argent ou votre responsabilité, c'est vous qui validez, pas l'IA.
Bien formuler sa demande
Les bonnes pratiques pour des prompts efficaces
Deux choses font un bon échange avec l'IA : la façon de mener la conversation, et ce que vous écrivez dans votre demande. Avec le même outil, la différence est nette.
Il n'existe pas de mode d'emploi de l'IA. Avec un logiciel classique, une notice dit : « faites ceci pour obtenir cela ». Ici, non. Bien écrire un prompt s'apprend en pratiquant, en essayant, en échangeant avec ses collègues. Cette page vous donne les bases ; à vous de les essayer.
D'abord, bien mener la conversation
4 habitudes de conversation
Elles ne demandent aucune technique : vous pouvez les prendre dès votre prochaine conversation.
01 / 04
Laissez l'IA vous poser ses questions
"Avant de répondre, pose-moi toutes les questions utiles pour améliorer ta réponse."
Pourquoi c'est utile
Pertinence
L'IA répond à votre vrai besoin au lieu de supposer ce que vous vouliez.
Découverte
Ses questions font apparaître ce que vous aviez oublié de préciser.
Gain de temps
Une bonne question au départ évite dix allers-retours.
02 / 04
Dites précisément ce qu'il faut changer
Plutôt que « non, ce n'est pas ça », dites ce qui ne va pas et ce que vous attendez : « plus court », « sans jargon », « garde le deuxième paragraphe ».
Pourquoi c'est utile
Qualité
« C'est faux » n'apprend rien à l'IA : elle ne sait pas quoi corriger. Une remarque précise, si.
Coût
Vous évitez la série « je précise, je précise encore », où chaque échange de plus se paie.
Pertinence
Vous trouvez ce qui manquait à votre demande : souvent l'objectif, ou la forme attendue. Ajoutez-le à votre prompt la prochaine fois.
03 / 04
Une conversation par mission
Tant que vous poursuivez la même mission, restez dans la même conversation. Nouvelle mission, ou réponses qui se dégradent : ouvrez-en une nouvelle.
Pourquoi c'est utile
Coût
À chaque message, le modèle relit toute la conversation. Plus elle est longue, plus chaque réponse coûte.
Écologie
Plus il y a de texte à relire, plus il faut de calcul, donc d'énergie, pour chaque réponse.
Pertinence
Dans une longue conversation, le modèle perd de vue vos premières consignes.
04 / 04
Faites-vous aider pour écrire le prompt, et gardez celui qui marche
"Aide-moi à bien écrire mon prompt." Ou, après une réponse décevante : "Qu'aurait-il fallu te demander ?"
Pourquoi c'est utile
Méthode
L'IA propose elle-même ce qui fait un bon prompt : le plan, le ton, la forme de la réponse. Cela s'appelle le méta-prompting.
Apprentissage
Vous comprenez ce qui manquait : c'est un cours particulier sur votre façon de demander.
Rentable
Le prompt qui marche se garde : rangez-le dans une fiche prompt (atelier 3) pour les demandes qui reviennent.
Ensuite, bien écrire sa demande
Les 6 informations à ne pas oublier
Un bon prompt dit six choses à l'IA. Les voici dans un exemple, chacune avec sa couleur.
Un prompt complet, information par information
1. RôleTu es formateur RH.2. TâcheRédige un email de relance3. Contextepour un apprenant qui n'a pas rendu son rapport de stage.4. Étapes1) salutation 2) rappel du retard 3) délai sous 3 jours 4) signature.5. ContraintesTon bienveillant, max 150 mots, pas de jargon.6. FormatFormat email professionnel.
1. Le rôle
Dites à l'IA qui elle doit être, et pour qui elle parle. Le rôle pose le cadre : le ton, le vocabulaire, le point de vue.
2. La tâche et l'objectif
Dites ce que vous attendez, et à quoi la réponse va vous servir.
3. Le contexte
Donnez ce qu'un nouveau collègue devrait savoir pour faire le travail : la situation, les personnes, ce qui s'est déjà passé.
4. Les étapes
Si la réponse doit suivre un ordre, donnez-le : d'abord ceci, ensuite cela.
5. Les contraintes
Indiquez les règles à respecter : le ton, la longueur, ce qu'il ne faut pas dire, le niveau de détail.
6. Le format
Précisez la forme de la réponse : une liste, un tableau, un plan, un paragraphe, un courriel.
Les techniques de prompting partent toutes de là : chacune approfondit l'une de ces six informations, se sert d'une fonction de l'outil (joindre un document, chercher sur le web, laisser l'IA réfléchir) ou vous aide à mener la conversation. Vous les travaillez dans l'atelier 2.
Vous savez maintenant comment un chat IA fabrique sa réponse. Reste une question : que lit-il exactement au moment de répondre ? C'est le sujet de la page suivante, la fenêtre de contexte.